Weniger ausgedachte Fakten, ohne zusätzliche Kosten
AttentionCD: Reducing Factuality Hallucinations in Large Language Models using Task-specific Head-based Contrastive Decoding (UncertaiNLP Workshop)
Ein Problem beim Einsatz von Sprachmodellen ist, dass diese gelegentlich mit hoher Selbstsicherheit falsche Informationen ausgeben, was gerade für KI-Anwendungen mit direktem Kundenkontakt ein großes Problem darstellt. In dieser Arbeit entwickeln wir deshalb eine Methode, um Modelle wesentlich zuverlässiger zu machen. Die Methode verbessert die faktische Genauigkeit im Durchschnitt um rund 11 Prozent und führt außerdem dazu, dass die Modelle seltener eine Antwort verweigern, wenn sie die richtige Antwort kennen.
Für kleine und mittlere Unternehmen bedeutet das vor allem, dass die Zuverlässigkeit von Open-Source-Sprachmodellen einfach erhöht werden kann, ohne dass das Modell aufwendig neu trainiert werden muss oder zusätzliche Hardware benötigt wird.
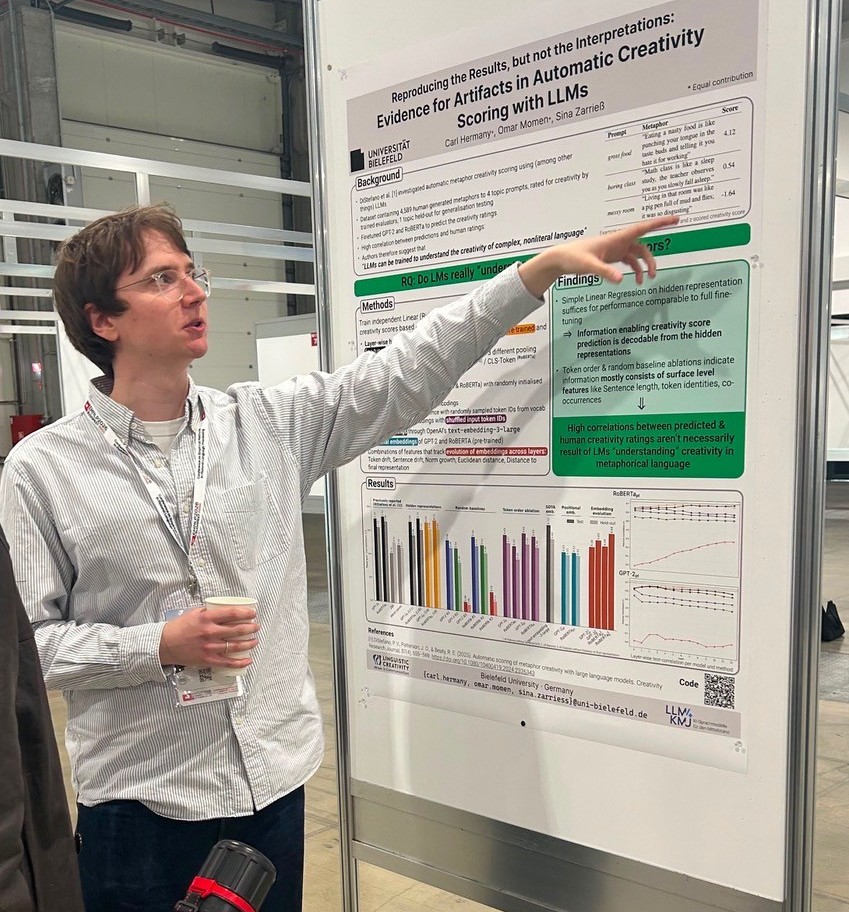
Gute Test-Scores sind kein Beleg für Verständnis
Reproducing the Results, but not the Interpretations: Evidence for Artifacts in Automatic Creativity Scoring with LLMs (BlackboxNLP Workshop)
Frühere Studien kamen zu dem Ergebnis, dass KI-Modelle die Kreativität eines Textes fast so gut beurteilen können wie Menschen. Bei genauerer Betrachtung stellten wir allerdings fest, dass sich die Modelle vor allem an einfachen formalen Merkmalen wie der Satzlänge orientieren und somit nicht wirklich verstehen, was einen Text kreativ macht.
Für kleine und mittlere Unternehmen bedeutet das: Auch ein Modell mit guten Testergebnissen kann die Aufgabe missverstehen oder auf eine unerwartete Weise lösen. Bevor Unternehmen KI für Bewertungen oder Entscheidungen einsetzen, sollten sie deshalb nicht nur prüfen, wie oft die Antworten plausibel erscheinen, sondern vor allem auch, auf welchen Merkmalen die Antworten beruhen.